

怪しい中華製品・販売終了製品・ジャンク品
どもーshoooです!
最近やたら登場しているこちら。
ASUS ROG STRIX GeForce RTX 3070 OC 8GB!

今回でRTX 3070記事3本目です笑
1本目では外観レビュー。
2本目ではSuperpositionや黒神話:悟空を使って、2026年現在でもゲームで戦えるのか色々検証しました。
そしてその記事のコメントで、

というリクエストをいただきました!
ローカルLLM…
名前は知ってるけど、正直何をどう測ればいいのかよく分かってませんでした笑
ということで今回は実際にローカルLLMを導入して、RTX 3070でどのくらいの速度が出るのか試してみます!
ローカルLLMを動かしてみる!
今回はできるだけ簡単に試したかったので、LM Studioを使っていきます!
何気にローカルLLMは初めてなのでAIに聞いた結果一番楽に入れられるということでこちらのLM Studioにしました。
LM Studioを導入

インストール自体は普通のWindowsソフトとほぼ同じ。
起動するとこんな感じ。思ってたより普通のAIチャット画面ですね。
今回使うモデル
ということで、AIに比較的新しく、そこそこ動くオススメのモデルを聞いた結果、
今回は、Google Gemma 4 E4B Instruct QAT Q4_0を使用します。

モデルサイズは5.15GB。
画面には「Full GPU Offload Possible」と表示されています。
まぁとりあえずRTX 3070でも動かせそうなのでヨシ!ということでダウンロードして進めていきます。
RTX 3070で実際に動かしてみる!
設定方法も完全にAI任せです。

このようにAIに指示された通りにPowerShellに打ち込んでいきます笑
見た感じモデルの読み込みは約5秒みたいです。
では実際に質問していきたいと思います!
「RTX 3070について500文字程度で教えてください。」と聞いてみました。
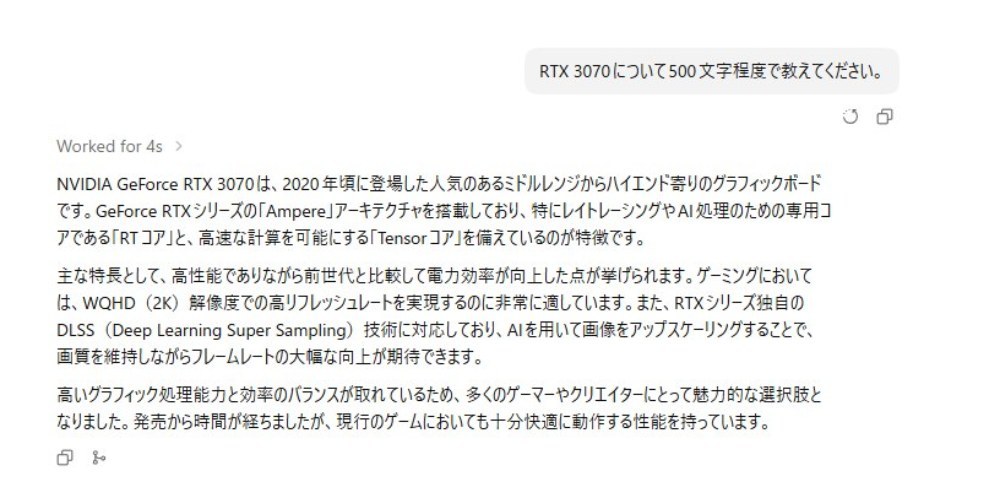
おお…
何気に普通に日本語で返ってきたのすごい笑
しかも体感かなり速い。
RTX 3070の特徴やDLSS、レイトレーシングなどについて、それっぽく説明してくれました。
RTX 3070で3回測定!
実際の速度も知りたいと思い、PowerShellからコマンドを送って実測値を確認することにしました。3回ほど同じ質問を回してみました!
今回はログに表示されるtokensPerSecondという値を見ていきます。
どうやら1秒間にどれくらい文章を生成できるかを見る数字らしいです。
まず1回目。

結果は…
93.25 tok/s!
続いて2回目。

結果は…
94.19 tok/s!
そして3回目。

結果は…
92.12 tok/s!
結果をまとめると、
| 1回目 | 93.25 tok/s |
|---|---|
| 2回目 | 94.19 tok/s |
| 3回目 | 92.12 tok/s |
平均約93.2 tok/s!
…と言っても、初めてなのでこの数字がどれくらい速いのか正直よく分かりません笑
ただ実際に使った感覚では、質問するとすぐ文章が流れてくるので待たされてる感じはほぼありませんでした。
個人的には普通に快適。
じゃあCPUだけだとどうなる?(Ryzen 7 5700X)
RTX 3070で快適なのは分かりました。
ただこれだけだと、どれぐらい速いのか、そもそもGPU使う意味あるのかもわからないため比較のためにも今度はRTX 3070を使わずにRyzen 7 5700Xだけで同じモデルを動かしてみます!
とりあえずAIに従い設定からGPUをOFF。

質問も全く同じ、
「RTX 3070について500文字程度で教えてください。」
を3回やろうと思います。
CPUのみ・1回目

結果は…
4.70 tok/s
…遅い笑
RTX 3070のときは文章が一気に生成されていましたが、CPUだけだと少しずつ文章が出てくる感じ。
回答が終わるまで1分以上かかりました。
CPUのみ・2回目

結果は…
5.07 tok/s
やはり1回目との結果はたいして変わらず、そしてやはりRTX 3070とは全然違います。
CPUのみ・3回目

結果は…
4.92 tok/s
3回ともほぼ5 tok/s前後でした。
まとめると、
| 1回目 | 4.70 tok/s |
|---|---|
| 2回目 | 5.07 tok/s |
| 3回目 | 4.92 tok/s |
平均約4.90 tok/s!
…遅い。圧倒的に遅いです笑
RTX 3070とRyzen 7 5700Xの最終比較表!
| 検証機 | 平均生成速度 |
|---|---|
| RTX 3070 8GB | 93.19 tok/s |
| Ryzen 7 5700Xのみ | 4.90 tok/s |
その差は約…
19倍!
いや違いすぎるでしょ笑
RTX 3070では数秒程度で終わった回答が、CPUだけだと1分以上かかりました。
数字を見てもすごいですが、実際に触ったときの体感差の方がかなり大きかったです。
今回のモデルや設定に限った結果なので、どんなローカルLLMでも19倍になるわけではないと思いますが、
というのは皆さんに伝わったと思います笑
実際ローカルLLMって使えそう?
今回初めてちゃんとローカルLLMを触ってみましたが思っていたより普通に使えました。
これが一番の感想です。
正直始める前は、
- 設定がめちゃくちゃ難しい
- 動かすだけで一苦労
みたいなイメージだったんですが、LM Studioを使えばモデルをダウンロードして読み込むだけで普通にAIと会話できました。
もちろん今回少し触っただけなので、ChatGPTなどの有料AIと比べてどこまで使えるのかはまだ全然分かりません。
モデルによって、回答の賢さもかなり違うんだろうなーと思います。
ただ、簡単な質問や文章作成であれば、個人的には普通に使えそう。
実際検証してこの記事を書こうと思ったきっかけになった前回の記事のコメントで、
「今後ローカルLLMが生活必需品になっていくかも」
という話もありましたが、実際触ってみると確かにこういうものがもっと一般的になっていく可能性はありそうですね。
最後に
ということで今回はRTX 3070記事3本目!
外観を見て、ゲーム性能を測って、ついにはローカルLLMまで動かしてしまいました笑
ゲーム用GPUというイメージが強いRTX 3070ですが、今回使ったGemma 4 E4Bでは平均93.19 tok/sと、自分が普通に使う分には十分すぎるくらい高速でした。
一方のRyzen 7 5700Xのみでは平均4.90 tok/s。
その差約19倍。
ここまで違うとは思いませんでした。
ローカルLLMについてはまだ全然分からないことだらけなので、今後もう少し大きいモデルだったり、別のモデルだったりも試してみたいですねー。
メインPCのRX 7900 XTXでも動かしてみたいなーと思っています。笑
ちなみにメインPCの記事はこちら!
↓↓↓
まとめ
今回はRTX 3070 8GBでローカルLLMが実際どのくらい使えるのか、LM StudioとGoogle Gemma 4 E4Bを使って試してみました!
今回の環境ではRTX 3070を使った方が約19倍高速という結果になりました。
何より驚いたのは、導入も動作も思っていたより意外に簡単だったこと。
まだ初心者なのでモデルや細かい設定についてはよく分かっていませんが、とりあえずRTX 3070 8GBでもローカルLLMを普通に動かせることは分かりました笑
とりあえずメインPCだとどれぐらい動くのか気になりますね。
あとローカルLLMで画像生成や動画生成も試したい欲が今まで以上に出ています笑
その前にGTX1060のベンチもしなきゃなぁ…
余談という余談ほどではないですが https://www.canirun.ai/ でブラウザを開くだけで(インストールや登録は一切不要)、サイトにアクセスするだけでGPUやメモリを自動検出して、各モデルのローカルLLMがどの程度動くか見ることができます。面白いので気になった方はぜひ見てみてください。
あとコメントで今回の記事みたいにリクエスト頂けるの嬉しいです!(ネタ提供感謝です!)
- RTX 3070でもかなり高速に文章を生成できた
- LM Studioなら初心者でも比較的簡単に導入できる
- モデルや設定についてはまだ分からないことが多い
評価
関連商品

いいね (1件)&足跡 (0件)

コメント (1件)
前後の記事
関連レビュー

ASUS ROG STRIX GeForce RTX 3070 OC 8GBを実機検証!2026年でも戦える性能か
行方不明だった「GTX 1060 6GB」を発掘!MSI AERO ITX 6G OCを外観レビュー
これもintel inside? ARCを使いこなす!

ASUS ROG STRIX GeForce RTX 3070の外観レビュー!バックプレートとRGBが魅力

RX 7900 XTXは2026年でも現役?数年経ったハイエンドGPUを実際に検証

パリットGTX760のヒートシンクを使ってみた!iPad第9世代の発熱を検証

約9年前のRX580 8GBは2026年でも現役?色々試してみた
[リベンジ]5050を売ってRTX5060を買い直した

メモリをそこまで使わないのもありがたい
そしてもっといいモデル使っても良さそうですね