

ブログ日記/その他
どもーshoooです!
今回は以前ゲームベンチなどを試したメインPCで、ローカルLLMを動かしてみようと思います!
メインPCのGPUはRadeon RX 7900 XTX。
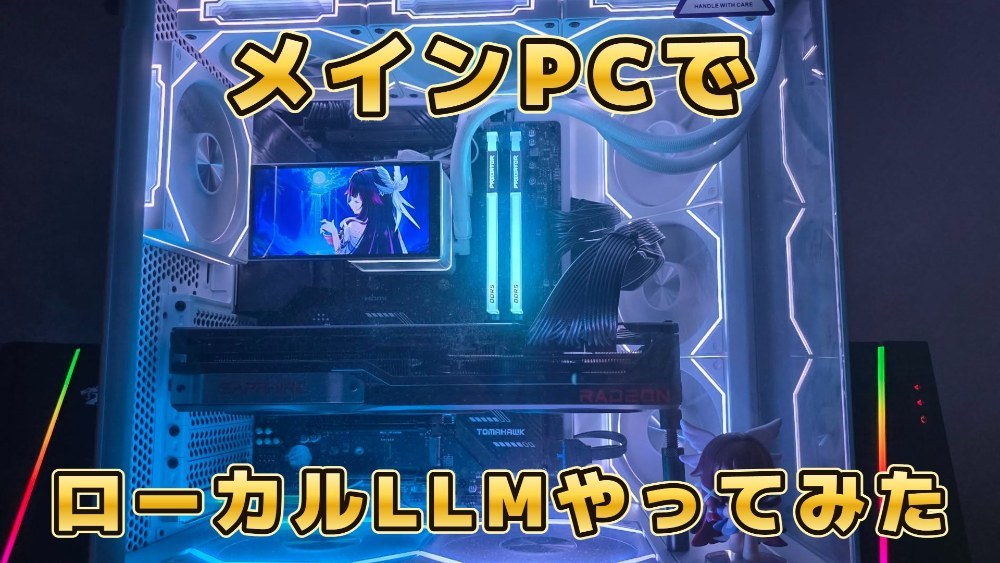
ゲーム性能については以前の記事で色々試しているので、今回は完全に省略!
前回のメインPC記事はこちら!
↓↓↓
RX 7900 XTXといえば、VRAMが24GB。
せっかくこんなにVRAMがあるなら結構デカいローカルLLMも動くんじゃね?笑
ということでサクッと試してみます!
CanIRun.aiで確認

まずは以前の記事でも紹介したCanIRun.aiで確認。
RX 7900 XTXを選択してみると、上位候補にQwen 3.6 35B-A3Bが出てきました。
35B…結構デカいですね笑
せっかく24GBもVRAMがあるので、今回はこれを試してみます!
LMStudio で早速いれる
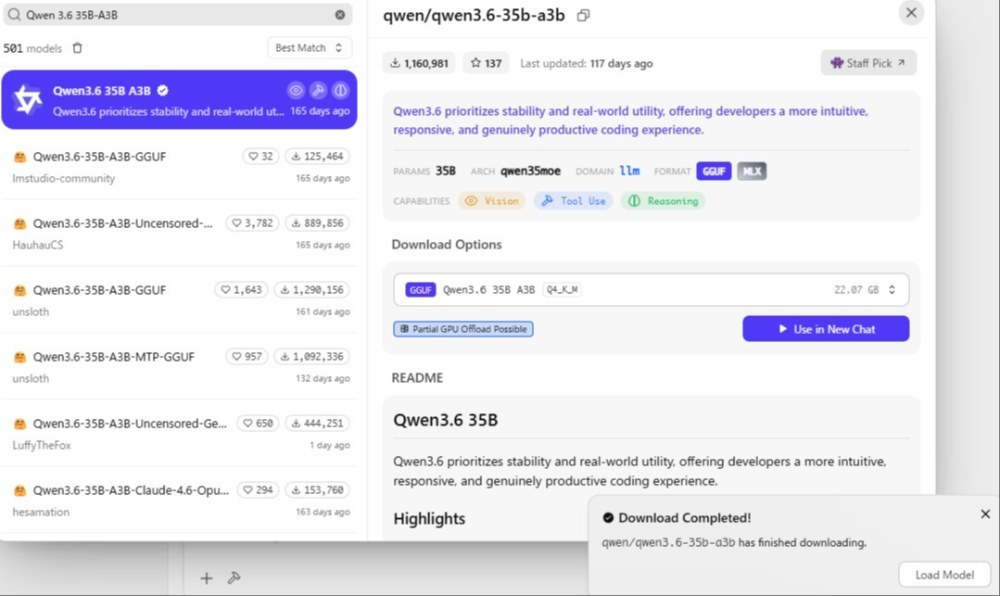
LM Studioで探してみると無事発見。
容量はなんと22.07GB。
LM Studio上では「Partial GPU Offload Possible」と表示されています。
24GB VRAMに対して22GB超え。
かなりギリギリですが、まぁ試しなのでそのまま行きます笑
実際に動かしてみる!
質問はシンプルに、
としてみました。
まずは、
Think(Reasoning)を使わず普通に生成


結果は…
67.72 tokens/s!
普通に速い。
22GBを超える35Bモデルですが、処理が止まることもなく最後まで回答を生成できました。
ThinkをONに
せっかくなので今度はThink(Reasoning)ONでも試してみます。


こちらは27.85秒ほど思考してから回答しました。
生成速度は…
65.52 tokens/s!
OFF時が67.72 tokens/sだったので、速度自体はそこまで変わりませんでした。
結論
ということで、RX 7900 XTXでQwen 3.6 35B-A3Bを動かしてみました!
22.07GBというかなり大きなモデルでしたが、普通にロードして回答まで生成できました。
速度は、
Think OFF:67.72 tokens/s
Think ON:65.52 tokens/s
という結果。
VRAM 24GBあるだけあって、ローカルLLMでも結構遊べますね。
ゲームだけじゃなく、こういう用途でも使えるのは面白い。
まとめ
今回はメインPCのRadeon RX 7900 XTXでローカルLLMを試してみました! 普段は完全にゲーム用として使っているGPUですが、24GB VRAMを活かせば35Bクラスのモデルまで動かせるのはなかなか面白いですね。 Think ONでも生成速度自体は大きく落ちず、約65tokens/sほどでました。
ほんと今回は本当にサクッと試しただけですが今後もっとうまく活用したいなーとは思ってます。
それでは!
- VRAM 24GBを活かせた
特になし
評価
関連商品

いいね (1件)&足跡 (8件)




前後の記事
関連レビュー

去年の夏に買った4070super。まともに検証してなかったのでベンチを取ってみる
【Radeon RX 7800 XT 16GB】を軽く検証!黒神話:悟空ベンチで動かしてみる!
ASUS RTX3070が熱暴走!Aairhut THERMAL PADで禁断の【グラボ手術】に挑戦

当時のハイエンド機 RTX2080Ti は今でも実用できる?

[オススメはしない]エンコード用に買ったintel Arc A310
玄人志向 Intel Arc B580 のレビュー!! 一週間使った結果!!
Intel Arc B580 GPUとはどれぐらいのレベル?NVIDIAやAMDと比べて?短期的だが正直な感想

【GALAKURO GAMING GeForce RTX 3060 12GB】を実機検証!FHDゲームとローカルLLMの結果

コメント (1件)